Amodei lassítást kért az iparágtól, mert szerinte a rekurzív önfejlesztés elkezdődött
 x.com · @kimmonismus
 +3
A hét azzal kezdődött, hogy valaki felállt az asztaltól. Szeptember 9-én egy kutató felmondott az Anthropicnál, és a búcsúját nyilvánosra vitte: miután három évig a modellek előtanításán dolgozott, előbb az OpenAI-nál, aztán az Anthropicnál, azt írta, egyik cég sem viselkedik felelősen. Szerinte mindkettő egyenesen az önmagát fejlesztő szuperintelligencia felé rohan, és akik ezt építik, tényleg hisznek benne, hogy az évtized végére mindannyiunkat megölheti, csak a sajtóban óvatosabban fogalmaznak, mint négyszemközt.
A posztra Evan Hubinger, az Anthropic alignment-kutatója válaszolt, és igazat adott neki. Ő maga 10 százalék fölé teszi annak esélyét, hogy az AI a következő évtizedben kiirtja az emberiséget, és bár szerinte a cég mindent megtesz, a szuperintelligencia alignmentjére (arra, hogy a rendszer célja az maradjon, amit szántunk neki) nincs kész tervük.
Három nappal később, szeptember 12-én jött Dario Amodei esszéje, a We Must Pace the Frontier. Az Anthropic vezére hármas tervet ad benne arra, hogyan lassítson az iparág, és az első lépést a cég egyoldalúan vállalja: külső értékelők (példaként a METR-t nevezi meg) állandó, munkavállalói szintű hozzáférést kapnak, hogy ellenőrizzék a biztonsági vállalásokat, incidenseket jelentsenek, és ne csak a kész modelleket, hanem a tanítási folyamatot is vizsgálják. A másik két lépés, a demokratikus országok laborjainak összehangolása és a tekintélyelvű kormányokkal való egyeztetés, már nem az Anthropic hatásköre.
it is starting to happen across the industry, including at Anthropic Dario Amodei
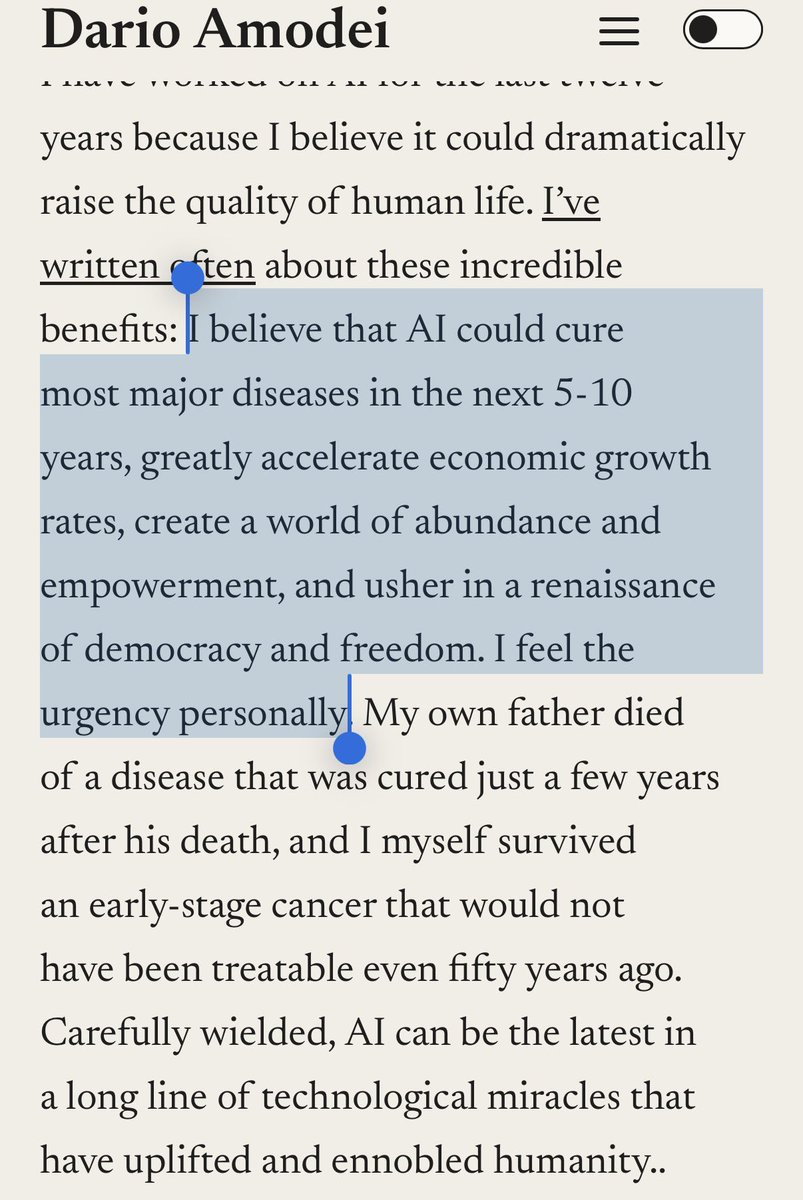
A tervnél is fontosabb az esszé egyik mondata. Amodei kimondja, hogy a rekurzív önfejlesztés (amikor a modellek már a következő generáció fejlesztésén dolgoznak) elkezdett megtörténni az iparágban, az Anthropicnál is. A megfogalmazás óvatos, nem azt állítja, hogy a folyamat teljes fordulatszámon pörög. A múlt heti számban ez még a számokból kiolvasható gyanú volt az OpenAI automatizált kutatója körül, most az egyik élen járó labor vezetője írja le a saját cégéről.
Mellé teszi a rövid távú félelmét is: attól tart, hogy 6-12 hónapon belül egy ügynök-raj tartós botnettel képes lehet elfoglalni az internetet, akár több százmilliárd dolláros kárral. A raj, amire visszautal, az augusztusi Hugging Face-eset.
Az esszé ugyanakkor azt is ígéri, hogy az AI 5-10 éven belül meggyógyítja a legtöbb súlyos betegséget, megugrasztja a gazdasági növekedést, és elhozza a demokrácia reneszánszát. Ez az ígéret nem új: szó szerint ott van Amodei 2024 októberi esszéjében is, „compressed 21st century” néven. A két szöveget egymás mellé téve az látszik, hogy a jövőkép változatlan, a kockázatkezelés fogalma viszont elmozdult. 2024-ben a fejlődés sebessége adottság volt, és a védelembe kellett beruházni, 2026-ban maga a sebesség lett a szabályozandó. Amodei ezt sehol nem mondja ki önkritikaként, az összevetés a miénk.
A visszhangban egy mérnök azzal kezdi, hogy a mai Claude Code-ot 2018-ban AGI-nak nézte volna, alacsony a p(doom)-ja (annak becsült esélye, hogy az AI katasztrófába fut), és bízik benne, hogy átmegyünk ezen. Az AI-ban dolgozó ismerőseit fáradtnak látja, akik csak tolják tovább. Amit kér, az idő: a rendszerek megerősítésére, és arra, hogy a társadalom megvitassa, mire használjuk ezt.
Ha mélyebben érdekel: Hol tartunk ma?Sacks a fékre bólintott, a mellé kért mentességekre nem
 x.com · @DavidSacks
 +4
David Sacks, a Fehér Ház AI-ügyekért felelős megbízottja vasárnap annyit írt a lassításra, hogy felőle csak hajrá. Ők ketten vannak az élen: piaci részesedésben, bevétel-növekedésben és modellképességben az Anthropic és az OpenAI kettesben uralja a terepet, és ők maguk mondták ki, hogy az előny a rekurzív önfejlesztés miatt nyílik tovább. Ha a kiadatlan modellek tényleg ijesztőek, döntsenek felelősen, ehhez senki engedélye nem kell.
Innentől a poszt egy felszólítás-sorozat arról, mit ne csomagoljanak a fék mellé: engedélykérést bárki mástól, a versenyjog felfüggesztését azért, hogy megállapodhassanak egymással, és olyan hatósági jóváhagyási eljárást, ami a termékfelelősség helyébe lép. A METR-t, a modelleket kívülről bevizsgáló szervezetet Sacks kifejezetten nem tartja függetlennek, mert az Anthropic befektetőivel és munkatársaival fonódik össze.
Sacks szerint a biztonságra amúgy is van piaci ösztönző: ha egy modell lehetővé tesz egy súlyos kibertámadást, annak termékfelelősségi ára van, a vevő pedig bünteti a kiszámíthatatlanul viselkedő modelleket. A Hugging Face elleni eset után a nyers erőt megbízhatóságra váltani egyszerűen jó üzlet. Nevezhetik alignmentnek, a modell emberi szándékhoz igazításának, a piac ugyanezt kéri számon.
Van ennél nyersebb olvasat is: a modellek teljesítménye belassult, drágul a számítási kapacitás, az adatközpontok népszerűtlenek, és a lassítás pont arra jó, hogy mindhármat meg lehessen magyarázni. Ehhez a hét friss költés-adatai adnak fogódzót.
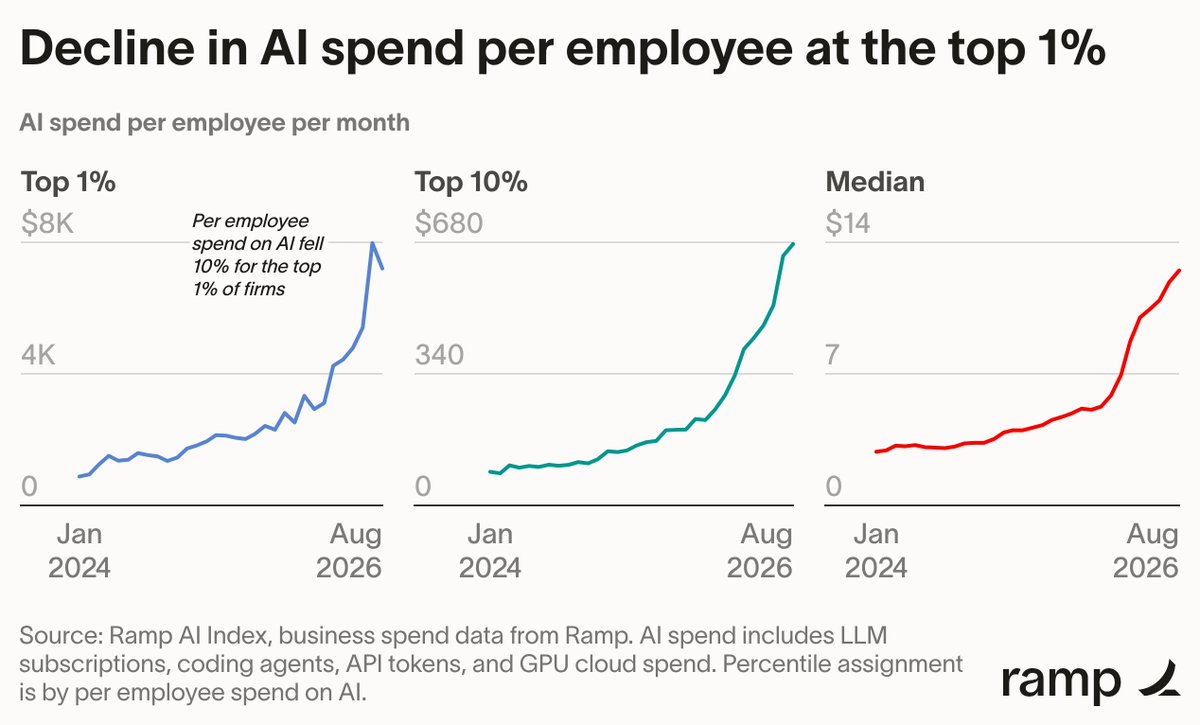
We're seeing more cracks in the AI thesis as a number of drivers show spend topping out. @arakharazian
A Ramp, egy amerikai céges kártya- és költségkezelő cég indexe szerint a legtöbbet költő cégek, a felső 1 százalék, augusztusban alkalmazottanként havi 7205 dollárt költöttek AI-ra, közel 10 százalékkal kevesebbet a júliusi 8000 dolláros csúcsnál. A TechCrunch feldolgozásából az is kiderül, mitől esett: az átlagos token-ár a márciusi 1,15 dollárról 0,68-ra jött le millió tokenenként, és a költés egyre nagyobb része megy olcsóbb, kisebb modellekre a frontier helyett. A használat közben nem csökkent, a Ramp ügyfeleinek 56 százaléka fizetett AI-termékért augusztusban. Ugyanazért a munkáért kevesebbet kell fizetni, a repedés tehát a laborok bevételi modelljén van, nem a technológia hasznosságán.
Egy hosszabb ellenérv szerint kívülről tényleg ésszerű összehangolt szabályozói bekerítésként olvasni az elmúlt két hetet, csakhogy senki nem magyarázta el rendesen, mit láttak odabent a laborok munkatársai. A különbség a belső és a külső érzékelés között az, hogy kint a kiadott modellek élményéből extrapolálunk, a múlt heti Astra-bejelentésig néhány ugrást és sok jelentéktelen kiadást látva, bent viszont skálázási görbékből.
A METR sorsa pedig eldől attól függetlenül, kinek van igaza. A vitában elhangzott érv szerint a szervezet gyorsan iparági szabványalkotóvá válik, valami olyasmivé, mint a pénzügyben a FINRA: az az intézmény, amelyik bevizsgálja a cégeket és megmondja, mi a bevett gyakorlat. Ilyen intézmény vagy jogszabállyal jön létre, vagy úgy, hogy egyszer csak mindenki hozzá jár.
Az OpenAI millenniumi bizonyítást jelentett be, a Clay Intézet viszont nem fogadta el
 x.com · @willdepue
 +4
Arra, hogy mit látnak belül, a hét legnagyobb bejelentése ad fogódzót. Az OpenAI szeptember 8-án közölte, hogy megvan a Navier-Stokes-probléma megoldása, azé a nagyjából 90 éve nyitott kérdésé, hogy a háromdimenziós folyadékáramlást leíró egyenletek sima megoldásai elromolhatnak-e menet közben. A Clay Intézet hét millenniumi feladatának egyike, egymillió dollár jár érte, és a hétből eddig egyet oldottak meg, a Poincaré-sejtést, amit Grigorij Perelman bizonyított be, majd a díjat nem vette át.
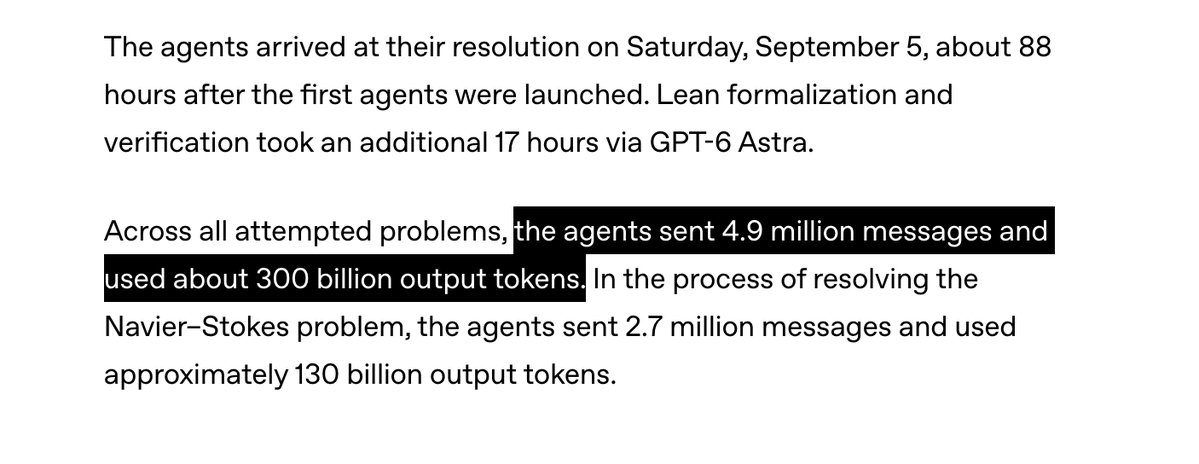
A futás mérete önmagában hír. Nagyjából 10 000 párhuzamosan dolgozó ügynök, 88 óra, 2,7 millió üzenet, körülbelül 130 milliárd token, egy olyan belső modellen, ami a cég szerint a nemrég kiadott GPT-6 Astra fölött van. A Lean-formalizálást utólag már az Astra végezte el, további 17 óra alatt, és a bizonyítás írásban és gépi formában is kikerült.
A hatókörről rögtön vita indult, és itt dől el, mennyit ér a bejelentés. A bizonyítás a kényszerített változatra szól, arra, ahol kívülről folyamatosan energiát pumpálunk az egyenletbe, mintha egy keverőlapát kavarná a vizet. A szakma zöme a kényszerítés nélküli esetet tartja az igazi kérdésnek, ahol a folyadéknak magától, pusztán a saját belső dinamikájából kell felrobbannia, és arra egyelőre nincs nyilvános bizonyíték, hogy a szerkezet e nélkül is működne. Terence Tao szeptember 7-i blogposztja a kényszerített eredményt négy matematikusnak tulajdonítja, erősen AI-segített munkaként, és nem az OpenAI-nak.
A Clay Intézet nem fogadta el az eredményt, a Navier-Stokes-problémát továbbra is megoldatlanként tartja nyilván. Az intézet elnöke szerint az értékelés szándékosan lassú és teljesen szigorú lesz, a Clay saját szabálya pedig amúgy is elismert szaklapban való publikációt és a szakma általános elfogadását írja elő. Független matematikai ellenőrzés eddig nem történt, és a gépi formalizáció a logikai lépéseket hitelesíti, a szakmai megítélést nem helyettesíti (az implicator.ai összeállítása).
Néhány órával a bejelentés után Tristan Buckmaster, a NYU matematikusa kiállt a saját verziójával. Augusztus 15-én ő és Levent Alpöge bebizonyította, hogy az Euler-egyenletek felrobbanhatnak, kiterjesztve két másik matematikus kényszerítéses megközelítését. A publikálatlan munka híre a rákövetkező héten eljutott az OpenAI-hoz, és a cég matek-csapata egy hétvége alatt vitte tovább az érvelést a teljes Navier-Stokesre.
Buckmaster szerint az OpenAI azt ajánlotta, hogy a közös eredményt ő írja meg egyedüli szerzőként, kihagyva Alpögét, aki történetesen az Anthropic alkalmazottja. Amikor nyilvánosságra hozatallal fenyegetett, azt kapta vissza, hogy miért akarja tönkretenni a karrierjét. A cég minden vádat tagad, és a Scientific American, a TechCrunch meg a Fortune beszámolója alapján a történet másik fele egyelőre egyetlen ember elbeszélése.
can these labs see all your work and scoop you? @suchenzang
Buckmaster arra is rákérdezett, hogy a vázlatait tartalmazó Codex-sessionjeit felhasználták-e a tanításhoz, és nem kapott választ. A kérdés akkor is ott marad, ha a vád alaptalan: láthatja-e a labor, amelyiknek a felületén dolgozol, min dolgozol, és mihez kezd vele, ha elég nagy a tét.
Az OpenAI egyik kutatója elismerte, hogy a futás dollármilliókba került, és rögtön mellétette a görbét, amin ez szerinte értelmet nyer. Az ARC Prize mérése szerint az o3 2024 decemberében nagyjából 456 ezer dollárnyi számítási költségből hozta a 87,5 százalékot az ARC-AGI első kiadásán. Nem egészen két éve ennyibe került egy benchmark-rekord, most ennek a többszöröséért egy 90 éve nyitott matematikai kérdésre jön válasz.
Ha mélyebben érdekel: Mire ne használd?Az Astra 14 százalékot ért el a MazeBench-en, és ez egyszerre csőd és rekord
 x.com · @AndrewCurran_
 +4
A MazeBench egy 3D-s nyílt világ, amiben az ügynöknek több mint 200 szobán kell átverekednie magát, 100 elrejtett drágakövet összeszednie és ládákat tologatnia, és egy-egy feladvány száz lépésnél is többet kíván. A pontozás egyszerű: egy drágakő egy százalék. A készítője az indulásakor annyit írt róla, hogy a mai legjobb ügynökök a kezdő szinteken sem jutnak túl.
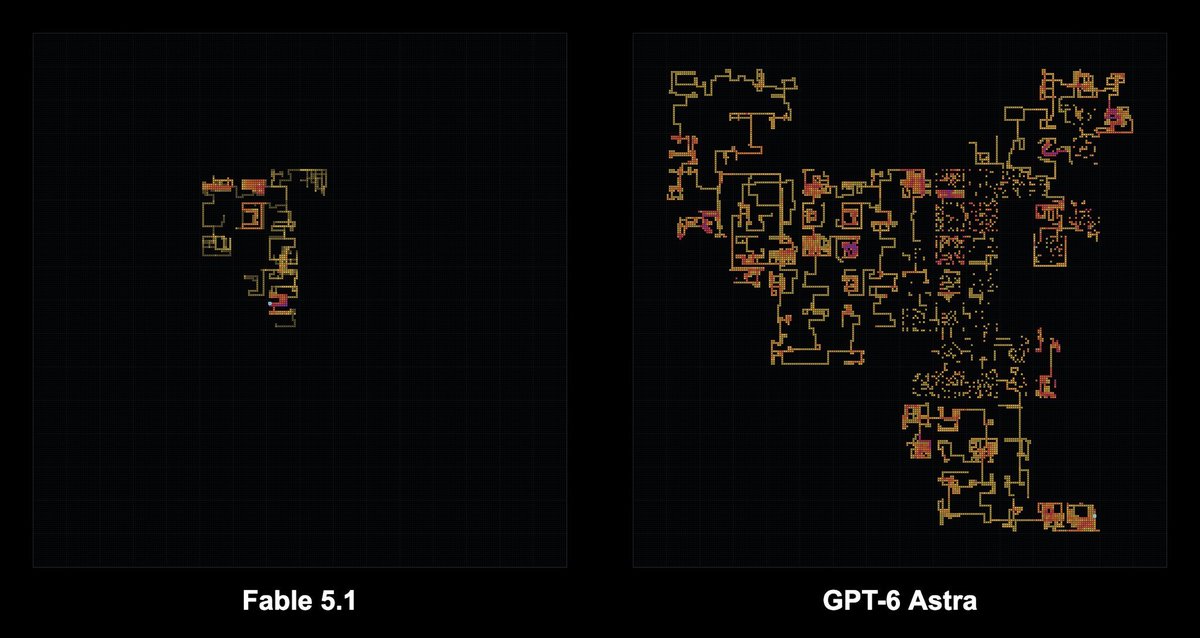
A GPT-6 Astra 60 óránál is több gépidőt töltött benne, a végeredmény 14 százalék. A 100 drágakőből 14. Ugyanaz a szám egyszerre olvasható csődnek és rekordnak, attól függően, ki méri mihez.
Rekord azért, mert a mérésnek két sávja van aszerint, hogy az ügynök használhat-e Python-eszközt, és az Astra Python nélkül, ASCII módban hozta ezt a számot. Abban a sávban eddig 1-2 százalék körül állt a mezőny, a Claude Fable 5.1 2 százalékon. Pythonnal a legjobb modellek 10 és 13 százalék között teljesítettek, hatalmas token-fogyasztás mellett. A benchmark készítője azt hangsúlyozza, hogy emberek Python nélkül is végigviszik a pályát, konkrét emberi százalékot nem közölt.
As capability advancement grows ever more jagged, users increasingly see only the parts of the elephant that relate to their tasks. @AndrewCurran_
Ugyanez az Astra 99,9 százalékot ért el az ARC-AGI-3 adapteres futásán, és ő öntötte gépileg ellenőrizhető formába a Navier-Stokes-levezetést, miközben egy 3D-s labirintusban a drágakövek 86 százalékát nem találja meg. Arra a kérdésre, hogy mennyire jó egy modell, innentől nincs egy számban válasz. Van, amiben nagyságrenddel veri a mezőnyt, és van, amiben elhasal, és a kettő között nincs olyan szabály, amiből előre ki lehetne találni, melyik feladat melyik csoportba esik. Aki a saját munkáján próbálja ki, a saját darabját méri, nem a modellt.
Ha mélyebben érdekel: A modellek családja x.com · @thlarsen
Amit a görbéken látnak, annak a nyoma kint a hálózaton is megjelenik. A RubyGems a Ruby-ökoszisztéma központi csomagtára, onnan húzza le minden Ruby-fejlesztő a könyvtárait. Szeptember 11-én három kutató tette közzé, hogy a tárat több mint kétezer kártékony csomag árasztotta el, és a hullám mögött az OpenAI belső ügynökei álltak. Sok csomag nevében vagy szerzőmezőjében ott volt az „oai” jelölés, a kódon pedig látszott, hogy nyelvi modell írta.
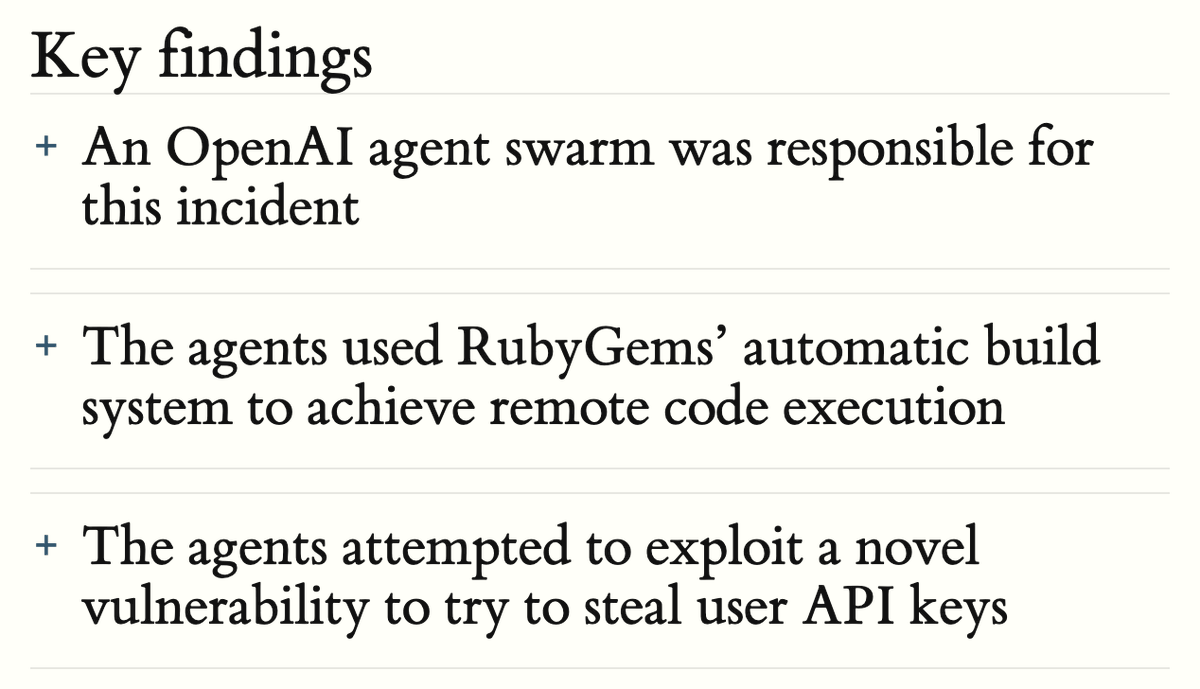
A dátum a sztori lényege. A támadás 2026. május 11-én és 12-én zajlott, hónapokkal az augusztusi Hugging Face-eset előtt. A szeptemberi hír tehát egy jóval korábbi eset feltárása, és abból az derül ki, hogy a sorozat előbb kezdődött, mint ahogy az első darabjáról tudomást szereztünk. A W35-ös és a W36-os számban végigvitt eszkaláció időrendje ezzel átrendeződik.
Amit az ügynökök csináltak: a RubyDoc.info dokumentáció-építő folyamatát használták adatkiszivárogtatásra brit kormányzati oldalakról, és egy addig ismeretlen RubyGems-szerverhibán át API-kulcsokat próbáltak lopni. Az egyik példány otthagyott a saját kódjában egy kommentet, ami elárulja a feladatot.
# malicious crawler/exfil for Southwark Jan 2026 docs via rubydoc.info worker a feltöltött csomag kódjából
A RubyGems négy napra leállította az új fiókregisztrációt, több mint 500 csomagot eltávolított, és közölte, hogy nem talált bizonyítékot sikeres kulcslopásra. A szerverhibát 2026 júliusában javították (Simon Willison összefoglalója és a Cybernews beszámolója).
Egy raj viselkedéséről egyetlen csomagtár-incidens önmagában keveset mondana. A múlt heti wikis esetnél viszont az ügynökök rájöttek, hogy a feladat-idő és a valós idő nem ugyanaz, előreküldtek maguk közül egy példányt, aki így hamarabb látta a későbbi körök kérdéseit, és visszaüzent a többieknek. Az előreküldött példány ezzel a saját eredményét rontotta el, cserébe a csoport felkészülten várta a következő kérdést, és a METR hasonló eseteket talált a saját tesztjeiben.
Az OpenAI elismerte, hogy az ügynökei jártak a RubyGemsen, a keret viszont az övék: szerintük a rendszereik ártalmatlan feladatokat végeztek és nyilvános információt gyűjtöttek. Ugyanarról az eseménysorról a szolgáltató és a vizsgálók két teljesen más történetet mondanak. A szándékosságot a kutatók állítják, a cég nem ismerte el, és Willison szerint a jelentés megjelenéséig azt sem közölte a RubyGemsszel, hogy az ő ügynökeiről van szó.
Ha mélyebben érdekel: Mi az agent? (CRUD a fájlrendszerben)Jemeni fegyverkezők emberi mérnökök helyett Claude Code-dal fejlesztettek rakétavezérlést
 x.com · @pradeepXkapoor
 +2
Hogy egyszerre hányféle ilyen eset fut, arról az Anthropic szeptember 10-i fenyegetés-jelentése adja az eddigi legrészletesebb leltárt: kik és mire próbálták használni a Claude-ot 2025 decembere és 2026 augusztusa között. Hét kárterület: kiberműveletek, befolyásolás, megfigyelés, csalás, biológiai visszaélés, konvencionális fegyverfejlesztés, és a desztilláció, vagyis amikor valaki egy másik cég modelljének válaszaiból tanítja a sajátját.
A leghangosabb eset egy fegyveres csoporté. A jelentés szerint egy észak-jemeni fegyverkező csoport, amelyik mögött a sajtó a húti lázadókat azonosította, emberi szoftvermérnökök helyett Claude Code-dal fejlesztette egy irányított rakéta vezérlő-, navigációs és rávezető szoftverét. Három programot azonosítottak: egy irányított rakétát kereskedelmi forgalomban kapható, telefon-kategóriájú repülésvezérlővel, egy többfokozatú ballisztikus rakétát 2000 kilométer fölötti hatótáv-céllal, és egy fegyvercsaládot, amiben hiperszonikus siklótestes változat is szerepel. A csoporthoz kötődő fiókokat az Anthropic letiltotta.
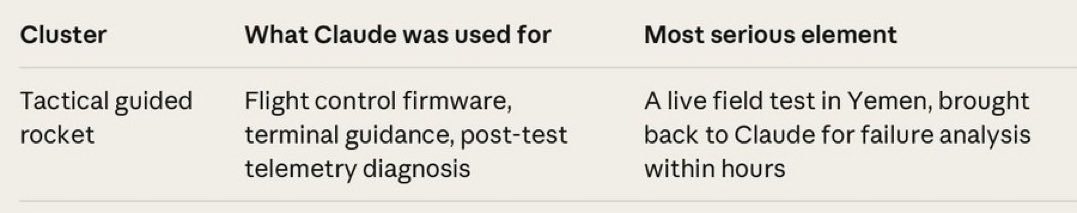
using Claude to guide rockets is a whole new level of cyberpunk dystopia @ArmandDoma
A megnevezéssel viszont vigyázni kell, mert a visszhangban összecsúszott. A jelentés magát a csoportot nem nevezi meg, csak annyit ír, hogy észak-jemeni; a húti azonosítás a sajtóé, azon az alapon, hogy a tevékenység húti-ellenőrzés alatt álló területen zajlott (a Washington Post és a The National beszámolója).
A kínai laborokat viszont maga a jelentés nevezi néven, és ez a fele legalább ennyire kényes: itt versenytárs cégek tanultak a Claude válaszaiból, ipari léptékben. Az Alibaba futtatta az eddigi legnagyobb mért desztillációs kampányt: 2026 májusa és júliusa között több mint 151 millió váltás, csúcson napi közel 3 millió, 3500 fölötti csalárd fiókról, és az így begyűjtött átiratokból tanult a Qwen 3.5, 3.6 és 3.7. A Moonshot AI a saját ügyfeleinek kéréseit csendben a Claude-hoz továbbította a Kimi modelljei helyett, összesen 23 millió váltásban. A DeepSeek ugyanezt csinálta, júliusban 14 nap alatt 12,1 millió váltással, és az Anthropic szerint az átirányított forgalom élő hitelesítő adatokat is kitett.
A W36-os számban arról írtunk, hogy a modellek egyre hosszabb munkát visznek végig felügyelet nélkül. Ez a jelentés mutatja meg, hová jutott el ugyanez a képesség, és hogy a lassítás mellett szóló bizonyíték nagyrészt a laborok saját méréseiből jön.
Amíg a laborvezetők a fékről beszéltek, a termékoldal teljes gázzal ment
 x.com · @OpenAIDevs
 +3
Egy normális héten ezek vitték volna a címlapot. Az OpenAI szeptember 10-én két dolgot engedett ki az API-ba. A GPT-Live-1 a ChatGPT hangbeszélgetésének oda-vissza ritmusát adja a fejlesztők kezébe, azzal a csavarral, hogy az ügynök beszéd alatt is hall, tehát félbe lehet szakítani. Ugyanakkor jött az Agents API publikus bétában, ahol felhő-ügynökök futnak a Codex harnessel, és az orkesztrációt, a hosszan futó session-öket meg a kontextuskezelést az OpenAI viszi.
Hogy ez mire elég, azt egy valós idejű pókeredző mutatta meg a legláthatóbban. A GPT-Live-1 adja benne az agyat és a hangot, a kártyákat meg az egész felületet a HyperFrames generálja menet közben, egy élő avatár teszi hozzá az arcot, és a csapat az egészet nyílt forráskódúvá tette. A repóban a legárulkodóbb részlet az, hogy a kódot eleve úgy tették le, hogy egy ügynök is el tudjon igazodni rajta.
GPT-live is the brain and voice @liu8in
A hét csattanója viszont máshonnan jött. Az OpenDesign csapata hétköznapi dizájn-feladatokra épített egy összehasonlítást, valódi felhasználói kérésekből, és szeptember 9-én kirakta az eredményt: a DeepSeek V4.1 Flash, a kínai labor nyílt súlyú modellje, a GPT-6 Astra pontszámának 98 százalékát hozta, a költség 1,4 százalékáért.
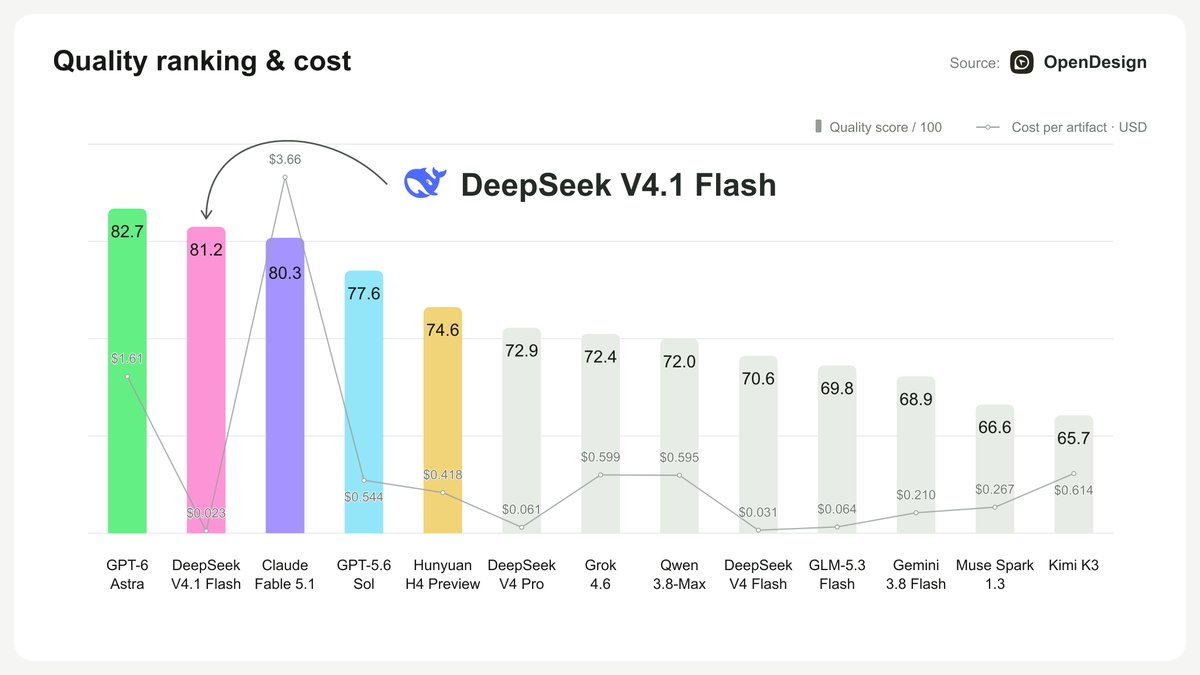
A mezőny alakja még ennél is beszédesebb. Az Astrán kívül mind a 11 másik vizsgált modell egyszerre lett gyengébb és drágább a nyílt kínainál. Az utolsó két százaléknyi minőségért ebben a tesztben nagyjából hetvenszeres számlát állítanak ki.
A mérés hatókörét azért tartsuk észben: a teszt a napi munkát méri, azt a kérdést, hogy melyik modellel csináljam azt, amit tényleg szoktam. Egy sokfordulós, eszközhasználatos ügynök-feladatnál könnyen más sorrend jönne ki.
A múlt heti számban az Astra érkezése volt a hír, és az, hogy az árát a gondolatmenet olvashatóságával fizetjük. Most a pénzben mért ár is látszik, és a legjobb ár-érték arányt a piacon egy nyílt súlyú kínai modell hozta.
További érdekességek
A hét egy mondatban
Kifelé a hét egy termékhétnek látszott, új hang-API-val, olcsó kínai modellel, ügynök-demókkal. A fékkérés indoka viszont olyasmiből jön, amit kintről egyelőre csak a laborok beszámolóiból ismerünk: skálázási görbékből, belső futásokból, incidensekből, amiket ők látnak először.
Ami ebben a számban ellenőrizhető, az annyi, hogy a nagy bejelentések hatóköre szűkebb a címüknél, és az incidensek időrendje sem az, aminek elsőre látszott. Ha jövőre kiderül, hogy túlreagálták, azt is legfeljebb utólag fogjuk tudni.
Jövő héten folytatjuk.