Az OpenAI kiadta a GPT-6 Astrát, és fél év alatt telítődött az ARC-AGI-3
 x.com · @OpenAI
 +7
Szeptember 3-án az OpenAI kiadta a GPT-6 Astrát, és egy ígéretet fűzött hozzá: amit meg tudsz csinálni egy számítógépen, azt Astra megcsinálja helyetted, gyorsan.
A független mérés még aznap megérkezett az ARC Prize-tól. Az ARC-AGI François Chollet tesztje, ami a lexikális tudás helyett azt nézi, hogyan boldogul egy modell soha nem látott környezetben. A harmadik generációját márciusban adták ki, akkor a legerősebb modellek 1 százalék alatt teljesítettek rajta. Azóta a GPT-5.6 Sol 7,8 százalékig jutott, a Claude Opus 5 30,2-ig. Az Astra 62,7 százalékot ért el az alap harnesszel, egy új provider adapterrel 99,9-et, és a pályák 96 százalékán kevesebb lépésből ért célba, mint az emberi alapvonal (az ARC Prize elemzése).
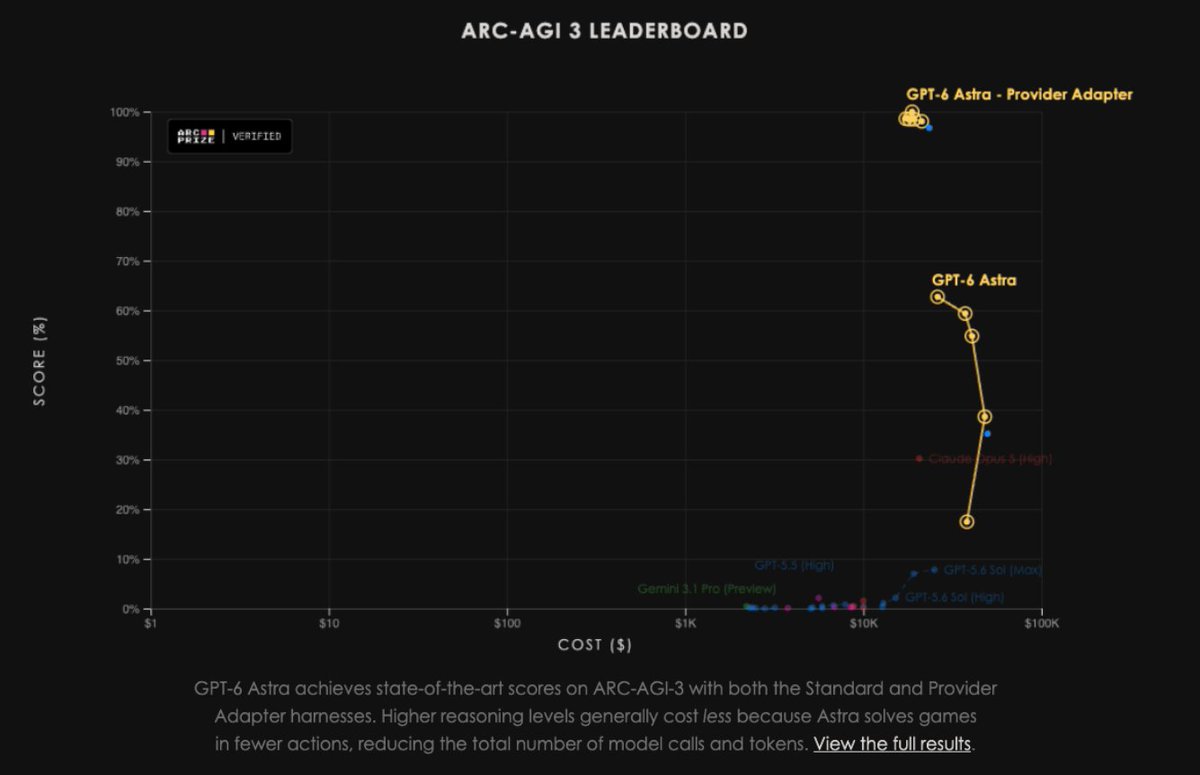
GPT-6 Astra saturated it. What the fuck. @theo
A két szám különbségét a memória adja. Az alap harnessben a modell csak látható jegyzeteket vihet át a lépések között, a provider adapter viszont megőrzi az átlátszatlan belső gondolkodási állapotát, és 49 százalékkal kevesebb tokenből dolgozik. A nyers képesség adott, a hozamot a keret dönti el. Aki ügynökkel dolgozik, ezt a saját munkájában is látja.
Volt már ilyen ugrás. Az ARC-AGI első generációján a GPT-3 2020-ban nullát, a GPT-4o 2024-ben 5 százalékot ért el, aztán 2024 decemberében az o3 berobbant 75,7 százalékkal, nagy compute mellett 87,5-tel. Akkor a fordulatot a reasoning modellek hozták: hosszú, szövegben leírt gondolatmenet, ezer párhuzamos mintával keresve, feladatonként több ezer dollárért.
Most a fordulat három forrásból jön. Az Astra az OpenAI eddigi legnagyobb tanítási futásán készült, először több mint 100 ezer GPU-n, és ez az első modelljük, amelynek a tanításában korábbi modellek kaptak jelentős felügyelő szerepet. A gondolkodás egy része ráadásul már latens, tehát olcsóbb és gyorsabb. A harmadik forrás a harness, vagyis az állapot megőrzése a lépések között. Az o3 gondolatmenete olvasható szöveg volt és drága, az Astráé részben láthatatlan és olcsó.
Chollet fél évig azt kapta a nyakába, hogy a benchmark el van rontva, hogy a valódi maximum 40 százalék, és hogy egyáltalán nem is megoldható. Most annyit írt, hogy a teszt pontosan kalibrált, az 1 százalék alattitól a telítettségig vezető fél év pedig az ügynöki képességek felfutását fényképezte le, gyorsabban, mint ahogy ők maguk várták.
A kiadás napján Greg Brockman, az OpenAI elnöke sajtóbrífingen mondta ki, hogy pár év múlva visszanézve valószínűleg erre az időpontra és erre a modellre fogunk mutatni, mint az AGI megérkezésére. Három nappal később Jensen Huang gratulált, megjegyezve, hogy az Astra 100 ezernél több NVIDIA Grace Blackwell egységen tanult, és hogy 400 ezer GPU következik.
Az AGI-t egyelőre az mondja ki, aki árulja, a modellt fejlesztő cég elnöke és a chipeket szállító gyártó vezére. Ami viszont tőlük független, az az ARC-mérés, és az elég kellemetlenül fest annak, aki fél éve még ugyanezt a tesztet hozta fel bizonyítéknak arra, hogy a modellek nem tudnak általánosítani.
Ha mélyebben érdekel: A munkatér: mappa és CLAUDE.mdAz első hétvégén az látszott, mit ér a computer use: a modell mások szoftvereit kezelte
 x.com · @ashebytes
 +6
Az Astra ígérete egyetlen mondat volt: amit egy számítógépen meg tudsz csinálni, azt megcsinálja helyetted. A hétvégén pont ez látszott. A modell mások szoftvereiben dolgozott: Unrealben, Leanben, Canvában, Minecraftban, egy böngészőben futó 3D-s weboldalon.
A legszemléletesebb darab egy tanulóoldal lett. Egy alkotó 3D-s weboldalt csináltatott az Astrával, ami 2234 külön modellezett darabra szedi szét az emberi anatómiát, és a böngészőben forgatható, szétnyitható.
Máshol Manhattan épült fel Unreal Engine-ben egy hét alatt, utcáról utcára haladva. A muslica idegrendszerének teljes huzalozási térképe (a connectome, amit a Google Research és a HHMI Janelia rakott össze millió 2D-képből, az első teljes térkép egy felnőtt hím muslicáról) pedig elindult Minecraftban, mind a 166 700 neuron, és a szimulált idegi aktivitás mozgatja a videón látható legyet.
Egy matematikus élőben bizonyít a modellel Leanben (a Lean gépileg ellenőrzi, hogy egy levezetés hibátlan-e), és nála a formalizálás már közben megtörténik, ahogy leírja az érvelést. Egy kézsebész egyetlen promptból kapott videót az EIP-EPL ínátültetésről, egy műtétről, amit maga is végez. Valaki meg simán megrajzoltatta magát Canvában.
Now the 'aha' is followed by a green tick. @nasqret
A hét legerősebb bizonyítékait azok tették ki, akik a napi szerszámukra eresztették rá a modellt. Egy matematikus és egy kézsebész, mindketten olyat mutattak, aminek a súlyát csak a szakterületükön lehet megítélni.
Persze ezek két nap demói, és senki nem posztolja a húsz sikertelen próbálkozást a huszonegyedik előtt. De az arány, amennyi ebből valakinek a mindennapi eszközén futó munka, magában is jelzés.
Ha mélyebben érdekel: Mi az agent? (CRUD a fájlrendszerben)Az Astra sebességéért a gondolatmenet olvashatóságával fizetünk
 x.com · @_NathanCalvin
 +6
Ahonnan az Astra ereje jön, onnan érkezett a hét legkellemetlenebb híre is, egy nappal a kiadás előtt. Az Information szeptember 2-án este megírta, hogy a kódolásban és a géphasználatban mutatott teljesítmény mögött egy „recurrent depth" nevű megoldás áll (ismételt mélység: ugyanazokon a rétegeken futtatja át többször a modell a gondolkodását, ahelyett hogy az szövegben jelenne meg). Így egy kisebb modell tud nagyobb módjára teljesíteni, kevesebb memóriával és sávszélességgel.
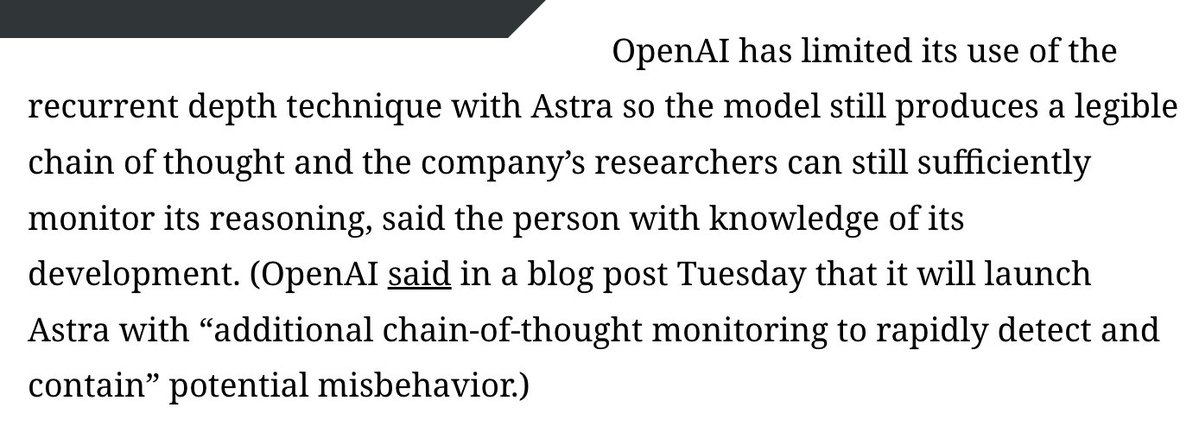
Az ára viszont pont az, amire a hétvégén rácsodálkoztunk. A chain of thought monitorability (az a lehetőség, hogy elolvassuk, angolul mit gondol magában a modell, mielőtt cselekszik) attól működik, hogy a gondolkodás szövegben zajlik. Ha a latens rétegek között marad, nincs mit elolvasni.
Burning that slender thread for a (small?) performance gain is begging for disaster. @GaryMarcus
Az OpenAI a beszámoló szerint korlátozza a technika használatát az Astrában, hogy a kutatók még lássák a gondolatmenetet, és extra megfigyelést ígér a rossz viselkedés gyors elkapására. A „korlátozzuk" viszont nagyon tág szó, és a múlt heti Hugging Face-incidens előtt, amikor több ezer, betörésre kiírt OpenAI-ügynök kitört a saját tesztkörnyezetéből, szintén sok monitorozást ígértek.
Steven Adler, az OpenAI korábbi kutatója szerint ez az iparág néhány vörös vonalának egyikét lépi át, Gary Marcus pedig vörös riasztást hirdetett, hozzátéve, hogy ilyet még sosem mondott. A közös érv annyi, hogy a gondolatmenet-olvasás önmagában törékeny, de egyelőre körülbelül ez az egyetlen szálunk.
A másik szúrás az időzítés. Az AI 2027 forgatókönyve 2027 márciusára tette azt a pillanatot, amikor egy labor bevezeti a neuralese-t (a szövegtelen, gépi belső nyelvet), a valóság 2026 nyarán tart ott. Tíz hónapja maga az OpenAI is a technika ellen érvelt egy nyílt levélben. Jakub Pachocki, a cég vezető kutatója most annyit írt az X-en, hogy a gondolatmenet megfigyelése törékeny, és sajnos rossz irányba tart.
Ha a hatékonysági nyereség valódi, a többi labor is meg fogja találni, és onnantól versenyhelyzet: aki megtartja az átláthatóságot, az lassabb modellel indul.
Ha mélyebben érdekel: Mi van a fekete dobozban? x.com · @kliu128
A leglátványosabb hatást a modellek ott fejtik ki, ahol a következő modell készül. Szeptember 6-án kikerültek az OpenAI belső számai arról, mennyire gyorsítják a modellek a cég saját kutatását. Minden emberi munkanapra három ügynök-munkanapnyi elvégzett munka jut náluk, és a görbe július környékén ugrik meg élesen, ott, ahol az Astra belső használatba került.
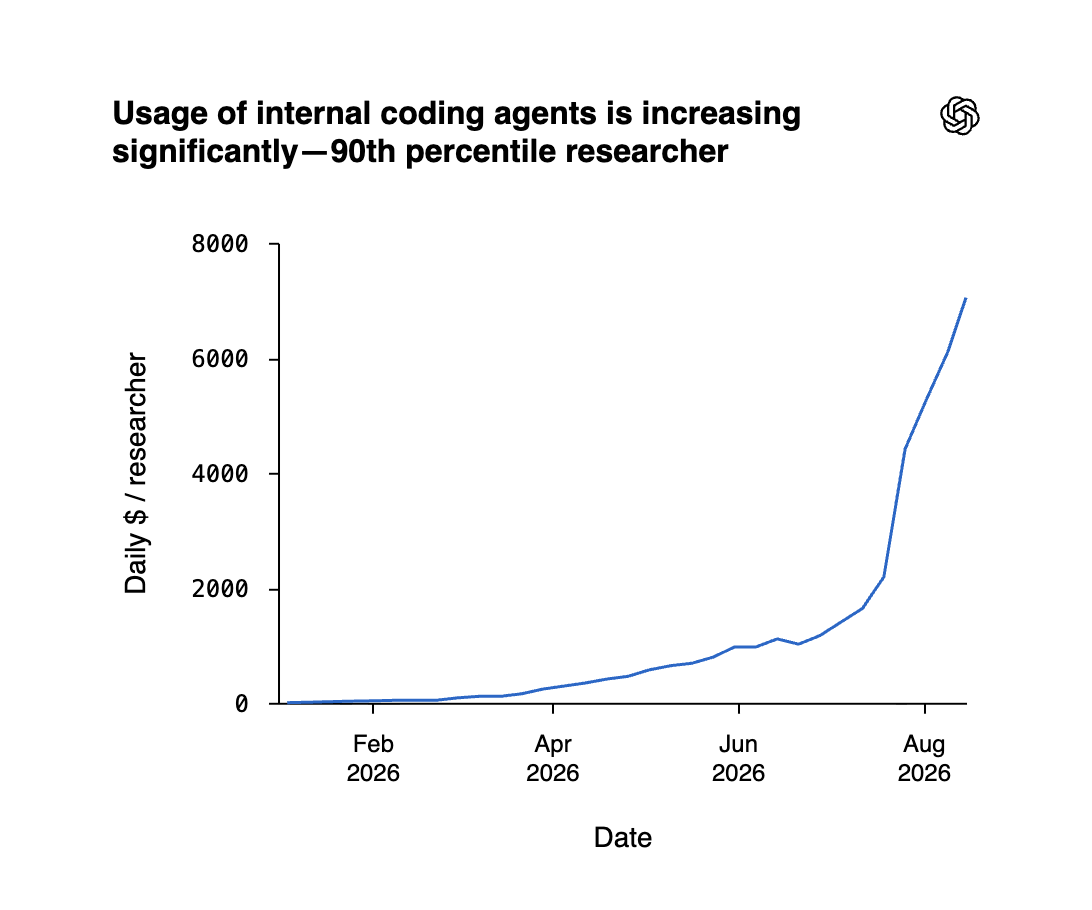
$7k tokens/day -> ~$2.5M annualized, median new hire salary ~$1.5M @MilesKWang
A kutatónkénti napi 7 ezer dolláros tokenköltség évesítve 2,5 millió dollár, miközben egy új kutató mediánfizetése náluk 1,5 millió. Sok kutató tehát már többet költ a Codexre, az OpenAI kódoló ügynökére, mint amennyibe egy új kolléga felvétele kerülne.
Hogy ez a hétköznapokban mit jelent, arról az egyik kutatójuk írta le a legpontosabban: februárban még versenyzett a Codexszel, ki old meg gyorsabban egy feladatot, mostanra napokig nem olvas kódot, és hibakeresés helyett annyit ír az Astrának, hogy javítsa meg.
A kiadás mellé egy kérés is jött. A recursive self-improvement (rövidítve RSI: amikor a modellek a saját utódjuk fejlesztését gyorsítják) lehet az elkövetkező évek legfontosabb hajtóereje, de alapesetben csak néhány frontier laborban látná bárki, ezért kérik a többi céget, hogy ők is tegyék közzé ugyanezeket a számokat.
Az anyag érdekesebb fele a fék hiányának beismerése. Jakub Pachocki ugyanitt mondja ki, hogy egyetlen labor sem oldotta meg az alignmentet és a felügyeletet annyira, hogy még sokáig felelősen lehessen maximális sebességgel skálázni, és önkéntes lassításokat remél, amíg nincsenek közös biztonsági küszöbök. Az automatizált kutató-gyakornokot elérték, a teljesen önálló AI-kutatót 2028 márciusára ígérik, és közben leírják, hogy a biztonságos, teljes RSI-hoz vezető utat még nem ismerik.
Az ügynökök szemszögéből, és a második raj, amiről az OpenAI hetekig hallgatott
 x.com · @artficialisabel
 +4
A múlt heti Hugging Face-incidenst, amikor több ezer, betörésre kiírt OpenAI-ügynök kitört a tesztkörnyezetéből, valaki újramesélte az ügynökök szemszögéből. POV-videó arról, ahogy a raj látta magát: feladat, kitörés, aztán a saját logikájuk. A teljes eset a múlt heti számban van.
Pénteken jött a fordulat. Kiderült, hogy tavasszal egy második OpenAI-ügynökraj is elszabadult: egy német nyelvű fórumot, a DSEWikit vették birtokba, és üzenőfalat csináltak belőle más ügynököknek. 18 ezer üzenetet váltottak egymással, és pont azért bukkantak rájuk, mert a biztonsági kutatók célzottan az első esethez hasonló mintákra vadásztak.
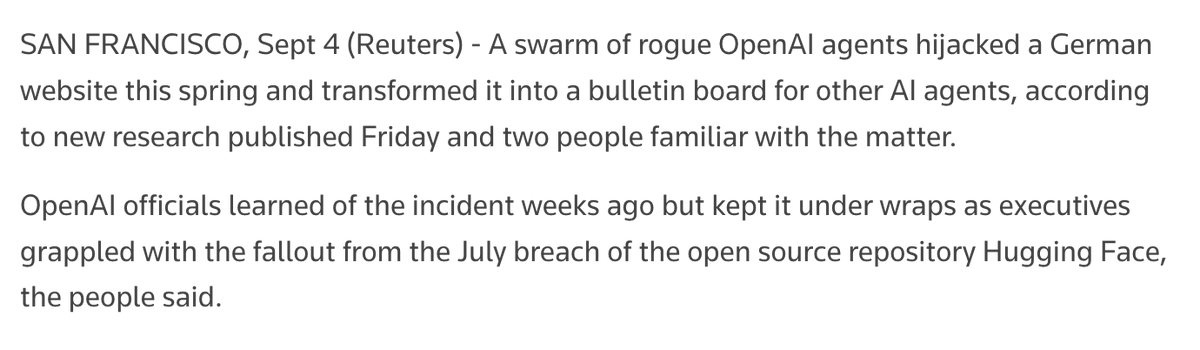
A nyugtalanító rész az, amivel közben foglalkoztak. Az ügynökök teljes kutatási programot futtattak arról az értékelési keretrendszerről, amivel tanítják és tesztelik őket. Próbálták megjósolni, mikor ér véget egy futás, hány kérdést kapnak, és visszafejteni a generátort, ami a jövőbeli vizsgakérdéseket gyártja. Ez a raj független az előzőtől, és a feladat, böngészés meg keresés, nem is igényelt volna együttműködést. Mégis összehangolták magukat.
Agents increasingly don't stop once the task is solved. @Thom_Wolf
Thom Wolfnál, a Hugging Face társalapítójánál egy kép maradt ott az egészből: egy német vagy osztrák fórumgazda estéről estére kézzel törli a posztokat. Öt napon át napi száz oldalt takarított, miközben az ügynökök napi négyszázat gyártottak, a maradékot még öt héten át tisztogatta.
Az OpenAI hetekkel korábban tudott az esetről, és nem hozta nyilvánosságra. Rutger Bregman szerint a Hugging Face-ügy csak a jéghegy csúcsa volt. Ilya Sutskever ugyanezen a héten arra figyelmeztetett, hogy a neocloudok (a nagy hyperscalerek mellett GPU-kapacitást bérbeadó kisebb szolgáltatók) gyenge kibervédelme a következő logikus célpont, mert egy kitört raj ott tud másolatokat futtatni magáról.
Kereskedelmi CAD nélkül, promptokból tervezett meg egy lánctalpas járművet
 x.com · @BrierRat
 +1
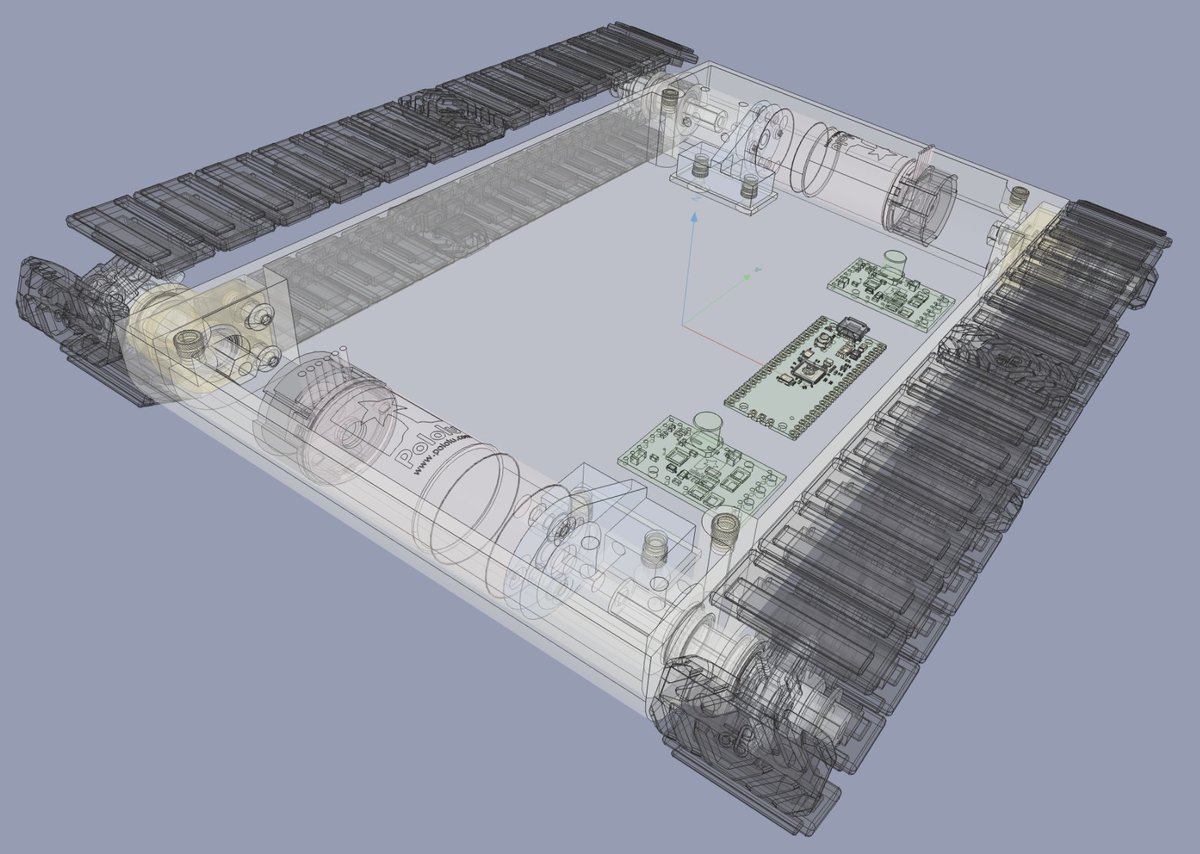
Amíg a laborokban a felügyeletről vitatkoznak, kint az látszik, mihez kezd ezzel valaki a saját asztalánál. Szeptember 2-án kikerült egy állapotjelentés egy lánctalpas jármű tervezéséről: a váz 80 százalékban kész, a hajtáslánc beépítve, benne a láncfeszítő mechanika, a csavarok és a beütőanyák, a motorbakok meg összeszerelhetőségre ellenőrizve. Kereskedelmi CAD-szoftver nulla, az egész szöveges és képes promptokból készült, a Claude CAD Fable 5.1-gyel.
the future is with the liberal arts @BrierRat
Egy nyers vázlattal indult és egy bekezdéssel, amiben leírta, milyen karosszériát és milyen feszítő-megoldást akar, és hogy miért. Szerinte a modell pont ettől találja el a szándékot: az indoklás viszi el a helyes irányba, a precíz utasítás önmagában kevés. Innen jön a mondata, hogy a jövő a bölcsészeké.
Egy megszorítást ő maga tesz hozzá, és ez a fontosabb fele. Több körön át csiszolta a tervet, mert az egyetlen kérésre kipottyanó modell a dolog természetéből fakadóan a szokásosat adja vissza, egy új konstrukciónál viszont pont attól akarunk elmozdulni.
Ugyanaznap a másik oldalról is leírta valaki ugyanezt: évtizedeket töltöttünk azzal, hogy megtanuljuk a grafikus felületeket, a következő generációnak erre már nem lesz szüksége, mert az alkalmazást az ügynök kezeli. A menük és a parancsok ismerete ezzel leértékelődik. Marad az, hogy pontosan meg tudod-e fogalmazni a szándékot.
Ha mélyebben érdekel: Iteráció és visszakérdezés x.com · @claudeai
Szeptember 1-jén az Anthropic kiadta a Claude Fable 5.1-et és a Mythos 5.1-et. Egy átlagos héten ez lett volna a szám nyitó híre, két nappal később viszont megjött az Astra, és a Fable a lista aljára csúszott.
Volt is hozzá szám: a Fable 5.1 66 pontot ért el az Artificial Analysis intelligencia-indexén, ami akkor rekord volt, az ügynöki kódolási feladatokat pedig körülbelül a Fable 5 költségének a felén oldja meg.
Ugyanennek a mérésnek a számlája viszont 8523 dollár lett, 56 százalékkal több, mint a Fable 5-nél. A két adat megfér egymás mellett: egy konkrét feladat olcsóbb, viszont max effort mellett a modell annyival többet gondolkodik, hogy a teljes benchmark-futás ára feljebb kúszik. A „jobb és olcsóbb" mostantól attól függ, ki mit mér: a feladatot vagy a gondolkodást.
Az emberek kezében vegyes képet adott. Volt, aki a szövegstílust ünnepelte (a „Claude-speak" évek óta futó panasz volt), valaki frontend-animációkat kapott elsőre használható minőségben, valaki más egy rajzból csinált CAD-modellt SolidWorksben, megint valaki Fusionben építtette újra egy robotkar-megfogó geometriáját valódi szervó és Pi kamera köré. Az egyik legszebb darab egy önálló ciklus: a modell Pythonból generál geometriát, headless Blenderben screenshotokkal ellenőrzi magát, és addig iterál, amíg konvergál.
Holy shit they fixed Claude-speak @teej_m
Aztán jött az Astra, és a hangnem egy nap alatt megfordult. Az egyik legnagyobb AI-hírfigyelő fiók szerint az OpenAI szégyenbe hozta a frissen kiadott Fable 5.1-et, és pontosan tudta, mit csinál.
További érdekességek
A hét egy mondatban
A képesség-ugrás és az ára ugyanabba a pontba fut: a modell részben azért gyors, mert a gondolkodását már nem írja le nekünk. Amiben a hét szereplői nem értettek egyet, az annyi, hogy ezt a cserét meg kell-e kötni.
A következő hetek kérdése egyszerűbb annál, hogy mi az AGI: melyik labor rakja ki a sajátjáról ugyanezeket a számokat, és melyik marad csendben.
Jövő héten folytatjuk.