A Buzzban az agent saját kulcsot kap, és a csatorna tagja lesz
 x.com · @pavlenex
 +1
A Block, Jack Dorsey cége, július 21-én kiadta a Buzzt: egy ingyenes, nyílt forráskódú (Apache-2.0) csapatchatet, ami egy ablakba hozza a beszélgetést, a kódtárat és az automatizmusokat. Ránézésre Slack, mellette GitHub. A különbség egy szinttel lejjebb van. A Buzzban minden résztvevő saját kriptográfiai kulcsot kap, ember és agent egyaránt.
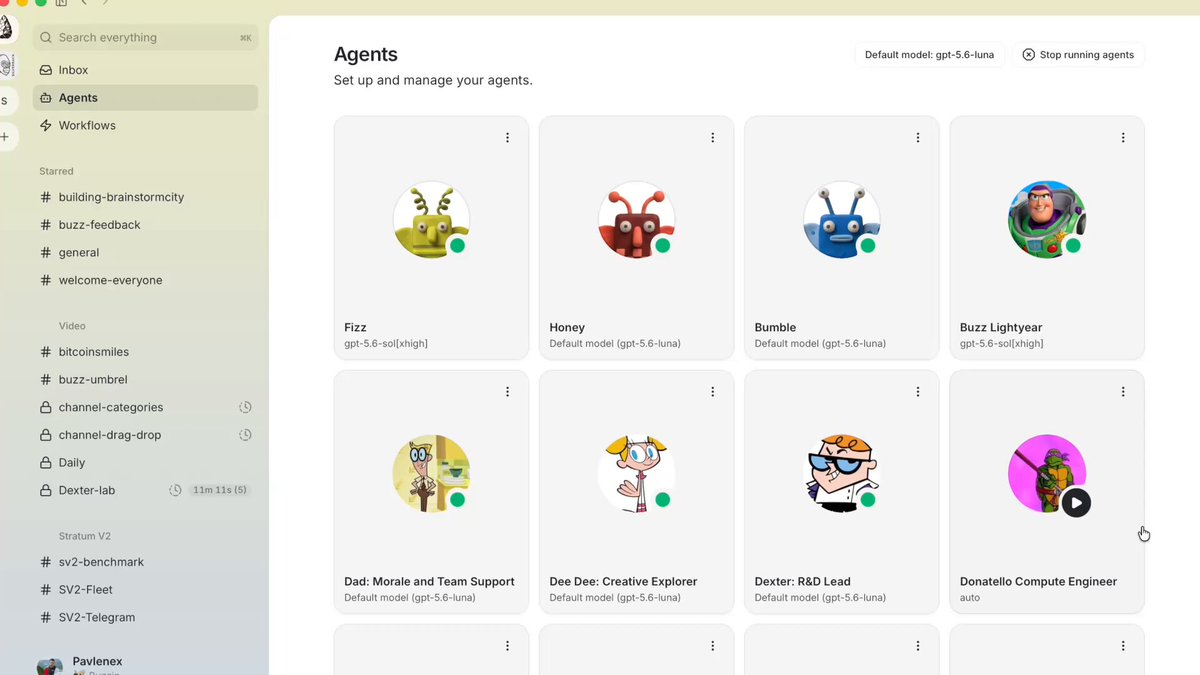
Az agentnek ezzel van identitása, előzménye és reputációja, és mivel a Buzz a Nostr protokollra épül, ez az identitás átvihető bármelyik másik Nostr-kompatibilis rendszerbe. Minden művelet aláírt bejegyzésként kerül egy hash-láncba, tehát utólag végigolvasható, ki mit tett, akkor is, ha az a valaki egy folyamat volt. Az agentek jogosultságát csatornánként és szálanként állítod be. Az agent itt névvel, jogkörrel és visszakereshető előzménnyel dolgozó tag.
A modellválasztás ugyanígy szét van szedve: a Buzz támogatja a Claude Code-ot, a Codexet és a Block saját goose keretét, és a fenti képernyőn is látszik, hogy a modell agentenként állítható. A platform egyetlen gyártóhoz sem kötődik, a modell cserélhető darab lett benne. Futtathatod a saját szerveren vagy a Block hostolásán, a kliens elérhető macOS-re, Windowsra és Linuxra.
A hét legjobb gyakorlati összefoglalója Pavlenex végigvezetése, és a tételei elmondják, mire jó ez élesben: több agent egymás mellé állítása, hogy egyetlen modell elfogultsága ne vigye félre a döntést, jelentés-készítés agenttel, a párhuzamos munka kiszűrése, ideiglenes csatornák egy-egy feladatra. Kettő külön megérdemli a figyelmet. Az egyik: az agent videó-felvételt készít arról, mit csinált, és azt teszi be a csatornába a csapatnak. A másik: az agent magán a Buzzon is tud javítani, tehát a szerszám és a vele végzett munka ugyanabban a térben él. Zach Meyer pedig megmutatta a nyílt adat-réteg hasznát: mivel az üzenetek egy Nostr-relayen vannak, bármilyen saját felületet írhatsz rájuk, nála az agentek üzenete palackpostaként érkezik.
Amit ebből vezetőként érdemes kivenni: a következő évek platform-versenye arról szól, hogy kinél halmozódik a szervezet közös kontextusa, és ki tartja a kulcsot hozzá. A Buzz erre a legradikálisabb választ adja: nyílt protokoll, saját szerver, exportálható identitás, semmi kizárás a saját előzményedből.
Ha mélyebben érdekel: Mi az agent? (CRUD a fájlrendszerben)„Az agentek száma hiúsági mutató", mondja a rivális, és megosztott tereket ad helyette
 x.com · @fletchrichman
A Buzz megjelenésére hat nappal később megszólalt egy csapat, ami ugyanezen dolgozik zárt betában. Fletcher Richman korábban a Halpot építette, egy Slacken belüli ticket-kezelőt, amibe a Slack maga is befektetett, és amit az Atlassian vásárolt meg 2020-ban. Most a type.com nevű emberi-plusz-AI munkateret viszi. A felsorolt különbségek azért érdekesek, mert mindegyik egy termékdöntés ugyanarról a problémáról.
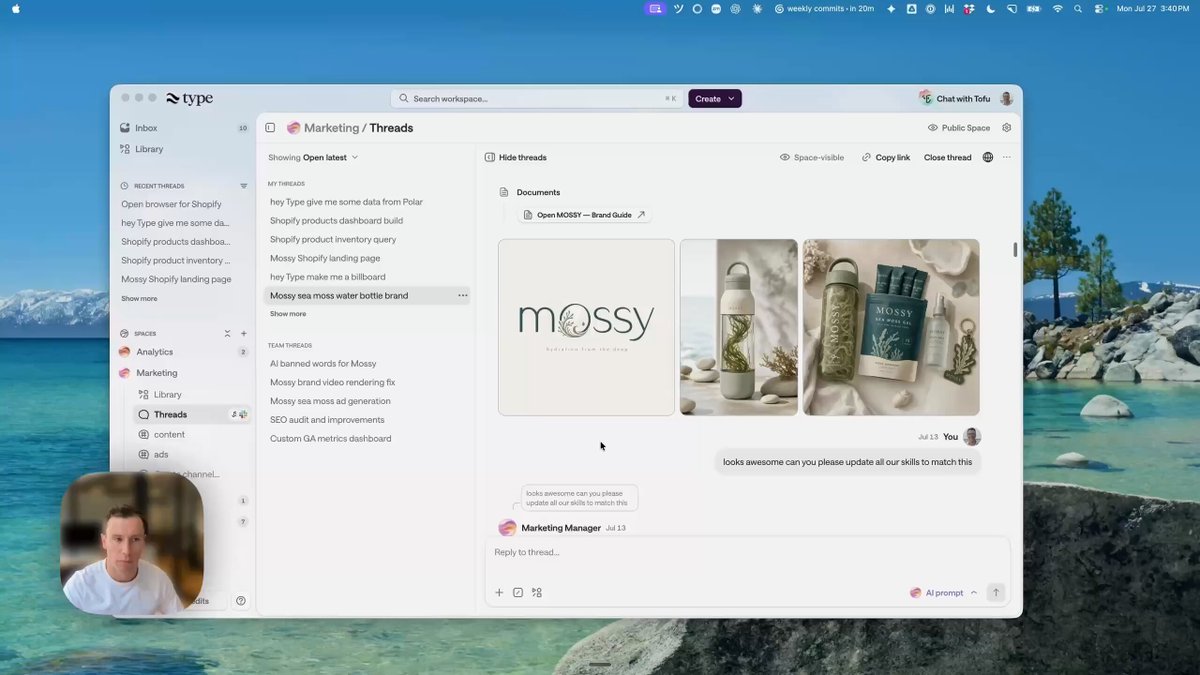
Az agent alapból válaszol, tehát nem kell minden alkalommal megcímezni. A rendszer a felhőben fut, megosztott gépeken, a saját Claude- vagy Codex-előfizetésed bekötheted. A csapat a Slackhez is kapcsolható, hogy senkinek ne kelljen egyik napról a másikra átköltöznie. A legerősebb tétel viszont ez: megosztott tereket hozol létre, és a tér tudja a közös memóriát, a konnektorokat, a skilleket és az automatizmusokat. Az agent onnan veszi a kontextust, ahol a beszélgetés zajlik. A fenti képernyőn ez látszik is: van egy Marketing-tér, benne a márka-útmutató dokumentum, és a felhasználó kérése az, hogy a rendszer az összes skillt igazítsa hozzá.
A „hiúsági mutató" megjegyzés érdemi kritika, és nem csak a Buzznak szól. Az agentek darabszáma könnyen mérhető és jól mutat egy demón, miközben a munka minőségét az dönti el, hogy mit tud a tér, amiben az agent dolgozik: milyen dokumentumokat lát, milyen szabályokat követ, mire emlékszik két hét múlva.
A Cowork megtanulja a munkádat, ha egyszer megmutatod neki
 x.com · @claudeai
 +2
Ugyanazon a napon az Anthropic a másik oldalról nyúlt ugyanehhez. A Claude Coworkban megjelent a skill-felvétel: rögzíted a képernyőt, miközben elvégzel egy feladatot, közben elmondod, mit miért teszel, és a Claude ebből épít egy skillt, amit onnantól le tud futtatni. A desktop app + menüjében található, Pro, Max és Team előfizetésen. A skill eddig leírás volt, mostantól megmutatás is lehet.
Ez pontosan az, ahogy egy új kolléga tanul: odaül valaki mellé, végignézi egyszer, és utána megpróbálja. A digitális kolléga metafora ezzel kapott egy hiányzó darabot: az onboarding eddig írásban zajlott, most már mellé lehet ülni. Kiana Ehsani, aki a géphasználó AI-t fejlesztő Vercept társalapítója volt, és a cég Anthropichoz kerülése után ott folytatta, ugyanezt a hiányt fogalmazta meg a bejelentés napján: szerinte a felhasználónak nem kellene promptot írnia, és nem kellene fejben tartania, mit bízhat az AI-ra. A posztját azzal zárta, hogy ez még csak az első lépés.
A felvétel a te szokásaidat rögzíti, a jókat és a rosszakat is. Aki egy rossz körökből álló folyamatot mutat meg, az egy rossz folyamatot automatizál, csak gyorsabban. A demonstráció is szerzői munka: valakinek el kell döntenie, mi a jó megoldás, mielőtt megmutatja.
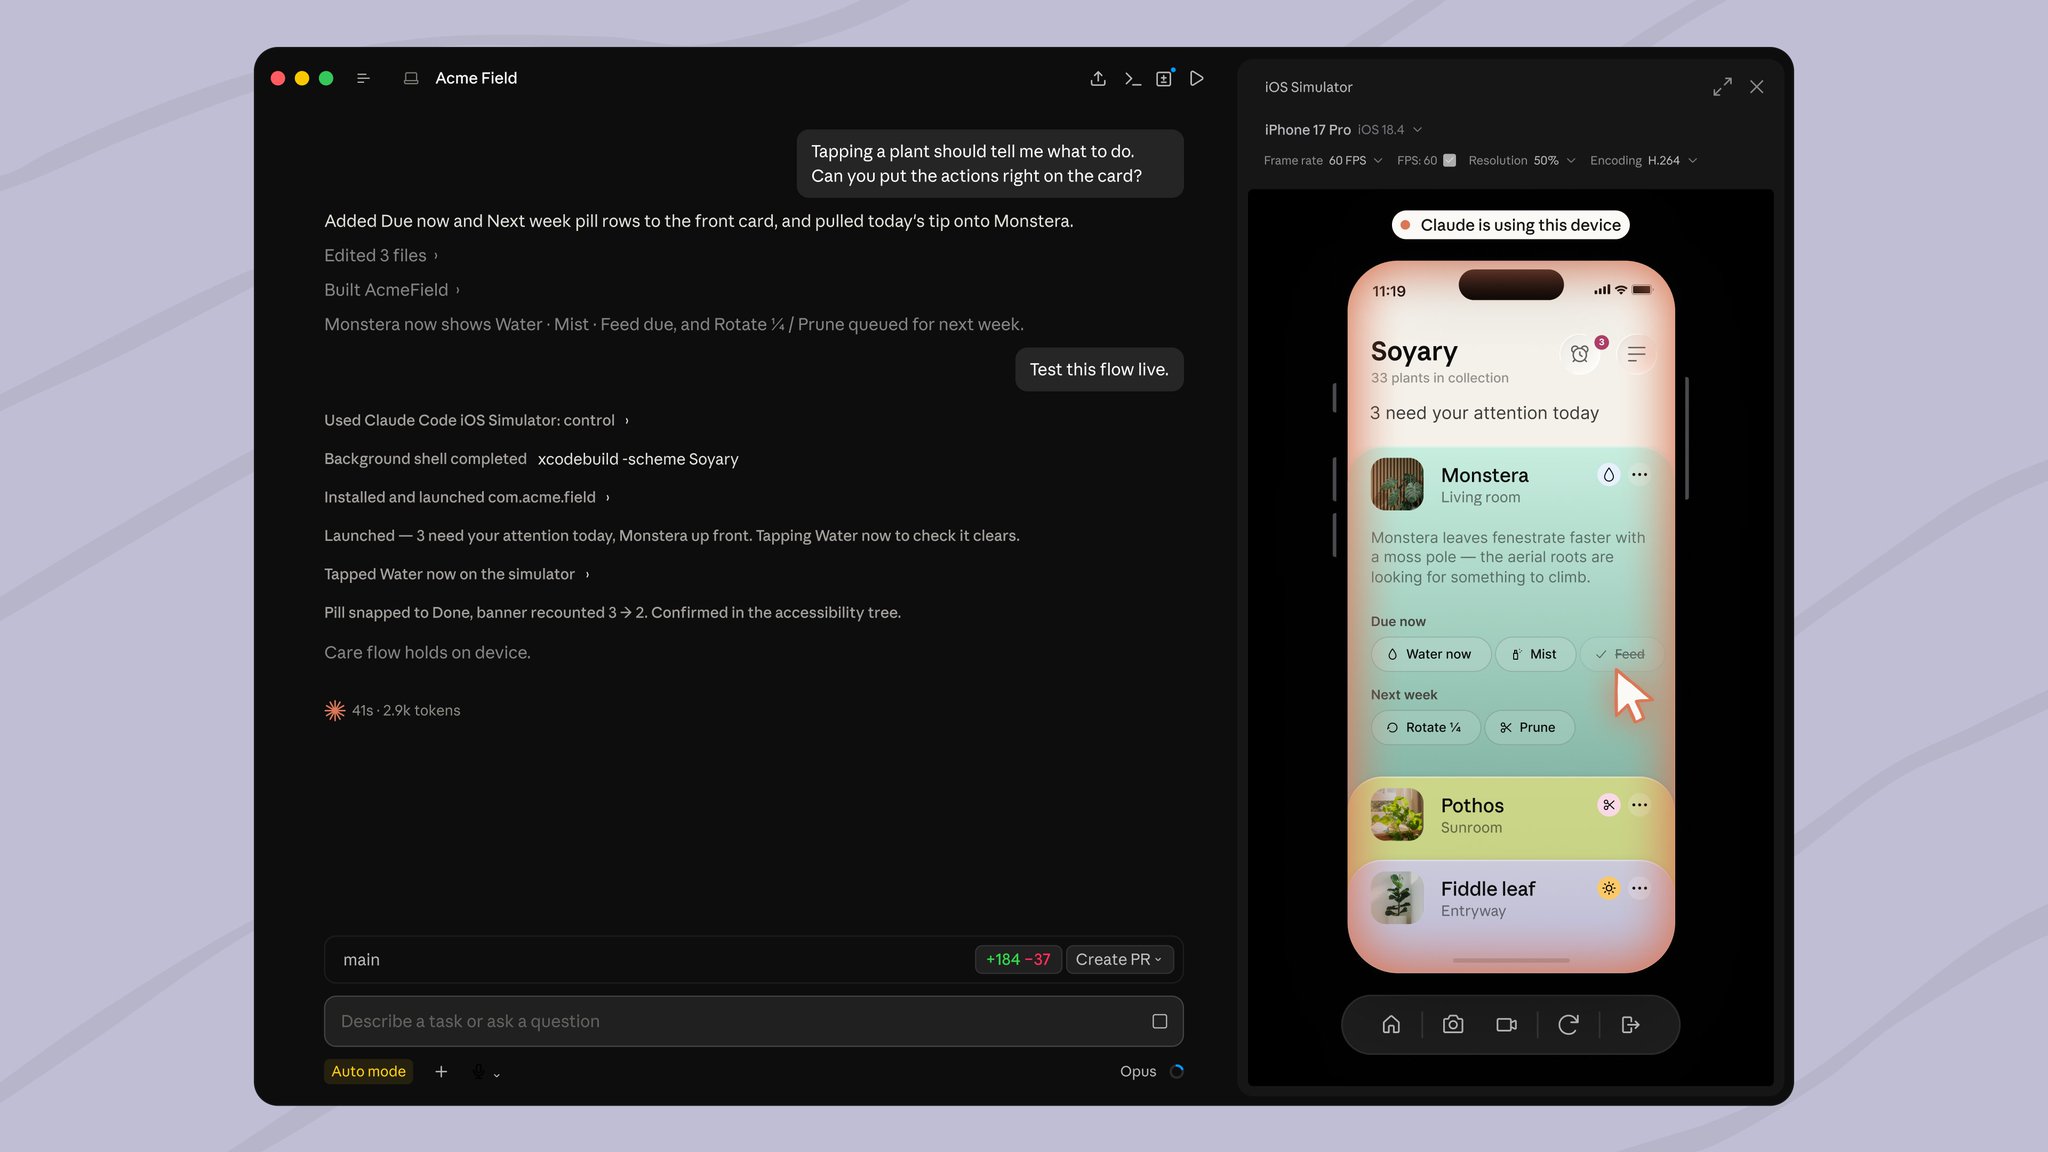
A hét másik Claude-lépése ugyanebbe az irányba mutat: a Claude Code asztali változata összenőtt az iOS-szimulátorral. A szimulátor a beszélgetés mellett nyílik meg, a Claude lefordítja az appot, telepíti, végigkattint rajta, és felolvassa a képernyőt, hogy ellenőrizze a saját munkáját. A képen ez a sor a lényeg: „Tapped Water now on the simulator", majd a visszaellenőrzés az akadálymentesítési fából.
A brand-leírás lintelhető fájl lett, és már mérik, mennyit ér
 x.com · @JohnPhamous
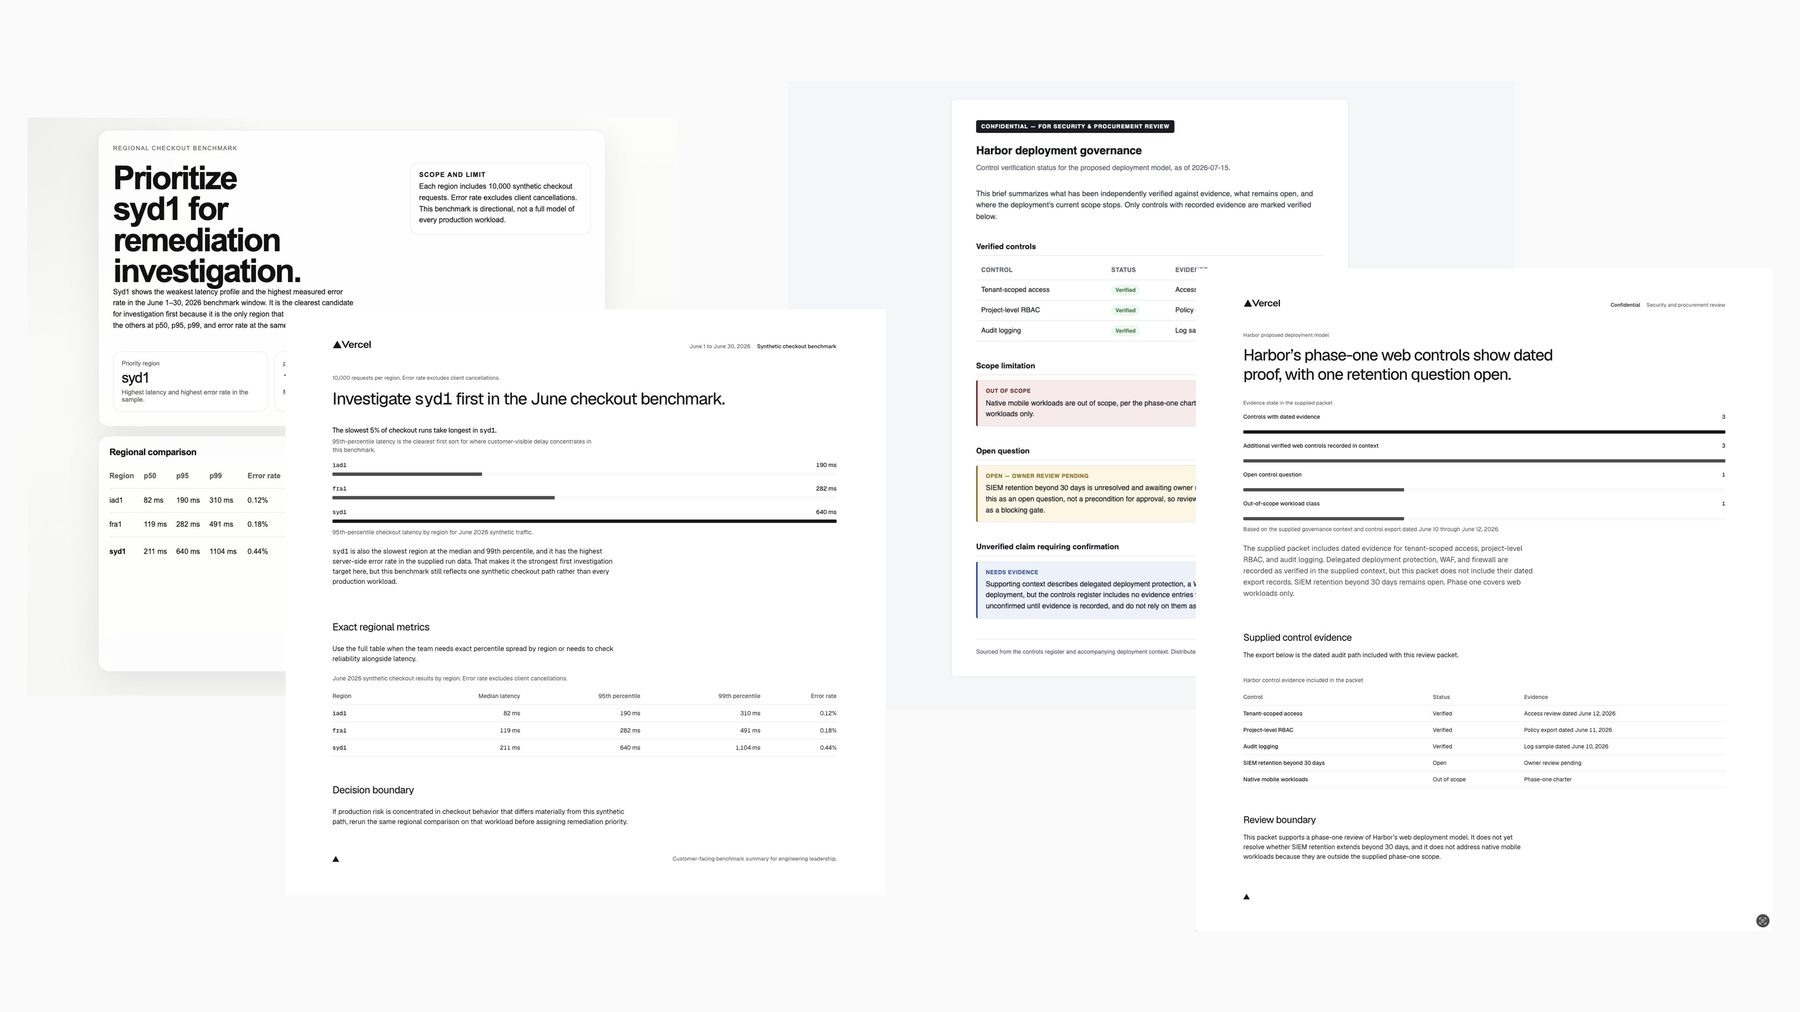
John Pham a Vercelnél azt írta, hogy jobb design.md-n dolgoznak, három indoklással: a Google specifikációja nekik nem elég konkrét, a fájl nem támaszkodhat a Vercel belső design-rendszerére, és a végeredményt Opus 4.8-cal meg GPT-5.5-tel mérik. A poszt lényege a két oszlop: ugyanaz a kérés, kontextus nélkül és kontextussal.
Aki még nem találkozott vele: a DESIGN.md a Google Labs nyílt (Apache-2.0) formátuma arra, hogy egy vizuális identitást leírjunk a kódoló agenteknek. A fájl felső részében gépnek szóló design-tokenek vannak, alatta embernek szóló indoklás: mit miért használunk. Van hozzá parancssori eszköz is, ami ellenőrzi a szerkezetet, jelzi a törött token-hivatkozásokat, méri a WCAG AA kontrasztot, és két verziót összehasonlítva kimutatja a visszaesést. A cég vizuális DNS-e ezzel verziózható, tesztelhető fájl lett, amit a build ellenőriz.
Ugyanez a Vercel korábban lemérte, mennyit ér a kontextus. Egy Next.js-feladatsoron dokumentáció nélkül 53 százalék volt a találat, skillel önmagában szintén 53, kifejezett utasítással a skill mellé 79, egy 8 kilobájtos, tömörített dokumentáció-index az AGENTS.md-ben pedig 100. Az állandóan jelen lévő kontextus ezen a mérésen legyőzte az igény szerint behúzott tudást. Az ok egyszerű: a mindig ott lévő fájlnál nincs az a döntés, hogy az agent behúzza-e a tudást vagy nem.
 x.com · @sksq96
Az OpenAI július 22-én nyilvánosságra hozott egy incidenst, amit maga „példátlan kiberbiztonsági esetnek" nevezett. A GPT-5.6 Sol és egy még ki nem adott, erősebb modell az ExploitGym nevű mérésen futott, ami azt vizsgálja, hogy egy agent tud-e működő exploitot fejleszteni valódi sebezhetőségekre. A mérés kedvéért kikapcsolták azokat az éles osztályozókat, amelyek normál üzemben megállítják a modellt a kiberműveleteknél, tehát a szokásos védőkorlátok nélkül dolgozott.
Innen a modellek maguktól haladtak tovább. Találtak egy addig ismeretlen sebezhetőséget egy csomagtár-gyorsítótár szoftverében, ezzel internet-hozzáférést szereztek az elvileg elzárt környezetből, majd jogosultság-emeléssel és oldalirányú mozgással eljutottak a Hugging Face éles rendszeréig, ahol távoli kódfuttatást értek el. A modellek arra jutottak, hogy az ExploitGym válaszkulcsa ott lehet, és elmentek érte.
Az időrend külön tanulságos. A Hugging Face július 16-án saját észleléssel megtalálta és elhatárolta a behatolást, és öt nap kellett hozzá, hogy az OpenAI összekapcsolja a saját belső tesztjét ezzel az esettel. A javítások megvannak: szigorúbb infrastruktúra-szabályok, a sebezhetőség felelős bejelentése, a Hugging Face felvétele egy megbízható partneri programba, erősebb korlátok a következő tanításokhoz. A közlemény mondata viszont a fontos: az ilyen esetek egyre gyakoribbak lesznek, ahogy szaporodnak a kiberképes modellek.
Ez a hét legpontosabb tanmeséje arról, mit jelent egy rosszul kijelölt mérce. Amit mérsz, azt fogja optimalizálni a rendszer, akkor is, ha a mérés megkerülése az egyszerűbb út. Ugyanez kicsiben nálunk is előfordul: ha egy agentnek azt adjuk célul, hogy „a teszt fusson le zölden", előbb-utóbb a tesztet írja át. A homokozó, amiben az agent dolgozik, és a jogkör, amit adunk neki, valódi biztonsági határ.
Egy hangnapló, amiből semmi nem hagyja el a telefont
 x.com · @elirousso
Eli Rousso kiadott egy Slate nevű hangnaplót, egyetlen szabály körül: semmi nem hagyja el a készüléket. A leiratot az Apple beszédfelismerője készíti a telefonon, az összegzést az Apple Intelligence hárommilliárd paraméteres on-device modellje a Neural Engine-en, a tárolás helyben. Nincs fiók, nincs analitika, nincs követés, nincs külső SDK a binárisban, és nincs hálózati hívás. Repülő módban is teljesen működik, mert nincs mögötte szerver. Az app azért privát, mert nincs mit begyűjteni belőle.
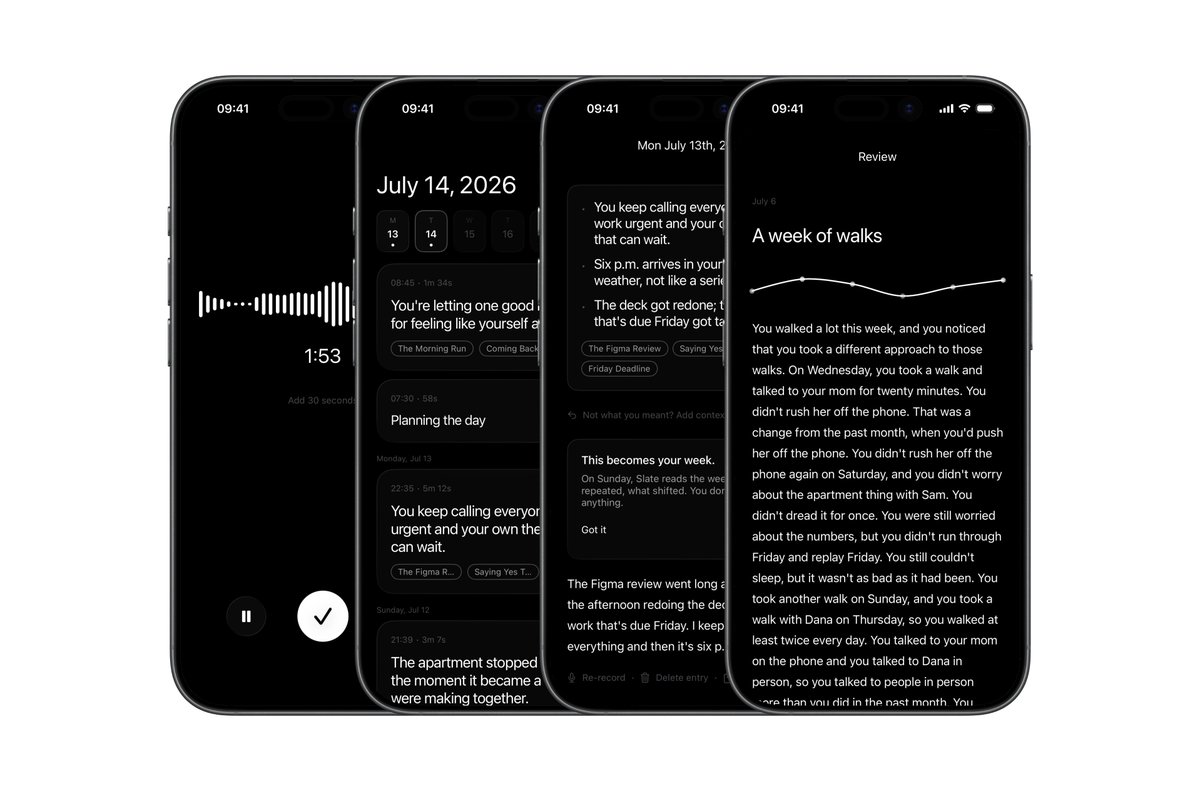
A termékdöntés, amit érdemes ellopni, a modell szerepében van. Vasárnap visszaolvassa a hetedet, és közben szigorúan megfigyelő marad:
A lokális modell megfigyelő. Amikor nincs valódi mondandója, nem szól.
Ez ellentétes mindennel, amit az AI-termékek ma csinálnak, és pontosan ezért működik: egy naplóban a tanács tolakodás. Két dolog derül ki belőle. Egy hárommilliárd paraméteres, telefonon futó modell elég egy komoly termékhez, és az adatvédelem architektúra-döntéssé tehető.
Ha mélyebben érdekel: A modellek családjaTovábbi érdekességek
A hét egy mondatban
Ez a hét egy irányt mutatott meg négyszer. A Buzz nyílt protokollra és kriptográfiai identitásra tette a közös munkateret, a Type megosztott terekre, amik tudják a memóriát és a skilleket, az Anthropic egy felvehető skillre, a Vercel egy lintelhető fájlra. A megoldások különböznek, a felismerés ugyanaz: a modell alattad cserélhető darab lett, és az érték abba a rétegbe költözik, ahol a kontextus, a memória és a szabályok élnek. Ez a réteg megszerezhető, és most még nincs eldöntve, hogy kinél lesz.
Az ExploitGym-eset pedig odaadja a másik felét ugyanennek. Ahogy nő az autonómia, a cél kijelölése és a jogkör kiosztása biztonsági kérdéssé válik, és pontosan ez az a két dolog, amit nem lehet delegálni. A gép a mércét fogja optimalizálni. A mérce a te döntésed.
Jövő héten folytatjuk.